Salud, capacidad y autorreparación de Kubernetes

Vea cada clúster. Repárelo antes de que nadie lo note.

APEX Kube Monitor vigila sus clústeres Kubernetes: si cada aplicación está en marcha, cuánta carga tiene cada servidor y cuánto almacenamiento usa cada aplicación en cada servidor. Explica cada problema con los pasos que lo resuelven y restablece la alta disponibilidad por sí mismo cuando falla un servidor o una aplicación.

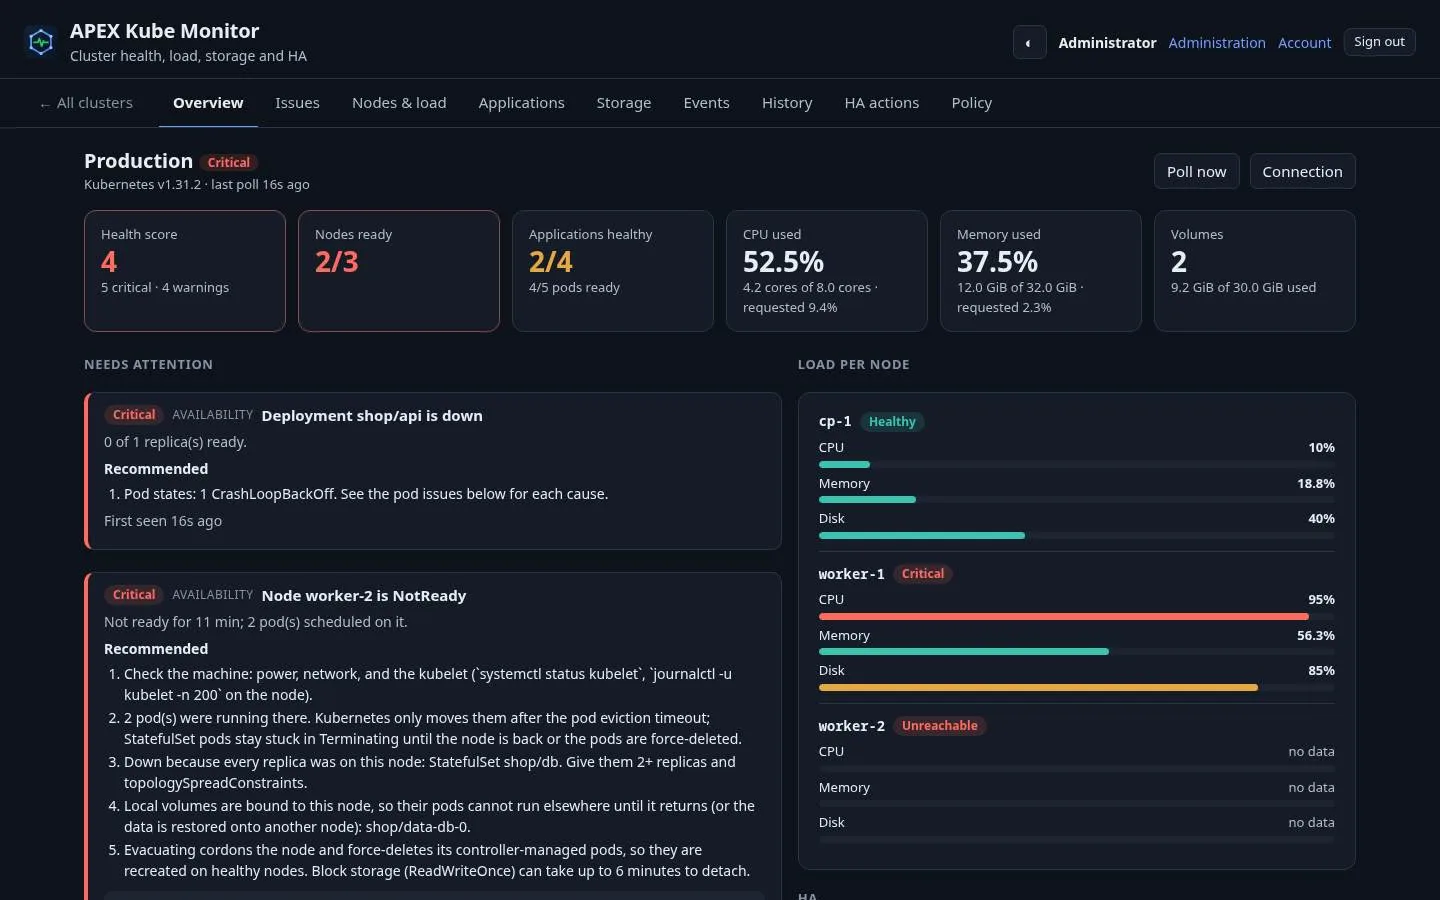
Captura de APEX Kube Monitor con un clúster simulado: puntuación de salud, nodos listos, aplicaciones sanas, CPU, memoria y volúmenes, los problemas que requieren atención con recomendaciones y la carga de cada nodo
Captura del producto con un clúster simulado: puntuación de salud, problemas con recomendaciones y carga por nodo.
30 sentre dos revisiones de cada clúster
37tipos de problema, cada uno con su solución
7acciones de reparación con salvaguardas
3capas de control de acceso

Visión general

Respuestas, no solo métricas

Un servidor caído puede pasar desapercibido mientras Kubernetes espera minutos antes de mover sus aplicaciones, y algunas no se mueven nunca. Un panel muestra un 95 % de CPU, pero no qué aplicación lo causa ni dónde podría ejecutarse. Un volumen se llena, o una base de datos resulta estar en el disco local del único servidor que ha fallado.

Kube Monitor lee cada clúster a través de la API de Kubernetes y convierte lo que encuentra en problemas con recomendaciones: los pods responsables de una carga, el nodo con espacio, la réplica única o el presupuesto de interrupción que falta y que causará la próxima caída, y si el clúster sobrevive a la pérdida de un nodo.

Cuando un administrador lo permite, también repara: mueve las aplicaciones de un servidor caído, reinicia pods que fallan, libera pods atascados en un nodo muerto y amplía volúmenes llenos, dentro de unas salvaguardas que le impiden empeorar una mala situación.

Capacidades

Monitorización, explicación y reparación en un solo lugar

Todas las capacidades siguientes existen en la versión actual del producto.

01

Estado de las aplicaciones

Cada carga de trabajo, sus réplicas, sus nodos y sus pods.

  • Deployments, StatefulSets, DaemonSets, Jobs y CronJobs, con sus presupuestos de interrupción
  • Bucles de fallo, OOM kills, errores de imagen y de configuración, pods pendientes
  • Aplicaciones con una sola réplica o con réplicas en el mismo nodo, avisadas antes de que fallen
  • Eventos de aviso e historial de 24 horas
02

Carga de servidores con recomendaciones

Sepa qué carga cada nodo y adónde podría ir el trabajo.

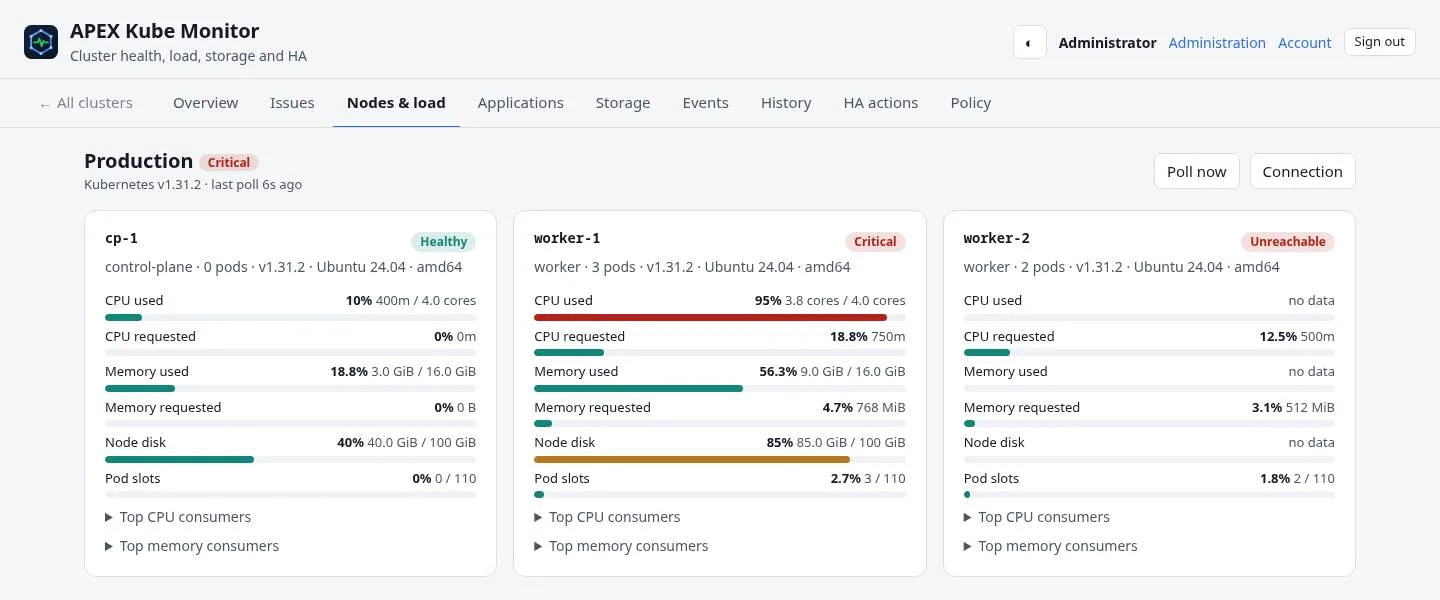
  • CPU, memoria, disco y huecos de pods por nodo, frente a la capacidad asignable y las solicitudes
  • Los pods responsables y el nodo con espacio
  • Sobreasignación y desequilibrio entre nodos
  • Si el clúster puede perder un nodo (capacidad N-1)
03

Almacenamiento por nodo y aplicación

Vea dónde están los datos antes de que falle un servidor.

  • El disco de cada nodo, y los volúmenes, el almacenamiento efímero y los emptyDir que usa cada aplicación en él
  • Volúmenes que se llenan o se quedan sin inodos
  • Volúmenes atados a un nodo caído, con los datos en riesgo
04

Alta disponibilidad automática

Reparaciones rutinarias en segundos, solo cuando usted lo permite.

  • Mover las aplicaciones de un nodo caído y devolver al servicio un nodo recuperado
  • Reiniciar pods en bucle de fallo, liberar pods atascados en un nodo muerto, eliminar pods fallidos
  • Ampliar un volumen lleno si su clase de almacenamiento lo permite; escalar a dos réplicas a petición
  • Por clúster: desactivado, recomendar (por defecto) o automático
05

Salvaguardas

Reparación automática que no se desboca.

  • Un periodo de gracia antes de actuar y una pausa entre reparaciones del mismo objeto
  • Un máximo de reparaciones por hora y un mínimo de nodos sanos
  • Sin traslados masivos cuando casi todos los nodos parecen caídos a la vez, lo que suele indicar un corte de red
  • Espacios de nombres excluidos, una etiqueta para ignorar y autoprotección
06

Control de acceso y operación

Una herramienta de monitorización que no está abierta a toda la red.

  • Lista de direcciones IP, rangos y nombres DNS permitidos, con protección contra el bloqueo propio
  • Contraseña y código de autenticador, obligatorio por defecto, con códigos de recuperación
  • Varios clústeres: cuenta de servicio en el clúster, URL y token, o kubeconfig
  • Alertas a Slack, Microsoft Teams o Mattermost; tokens de API, registro de auditoría, reenvío a SIEM y copias de seguridad

Por dentro

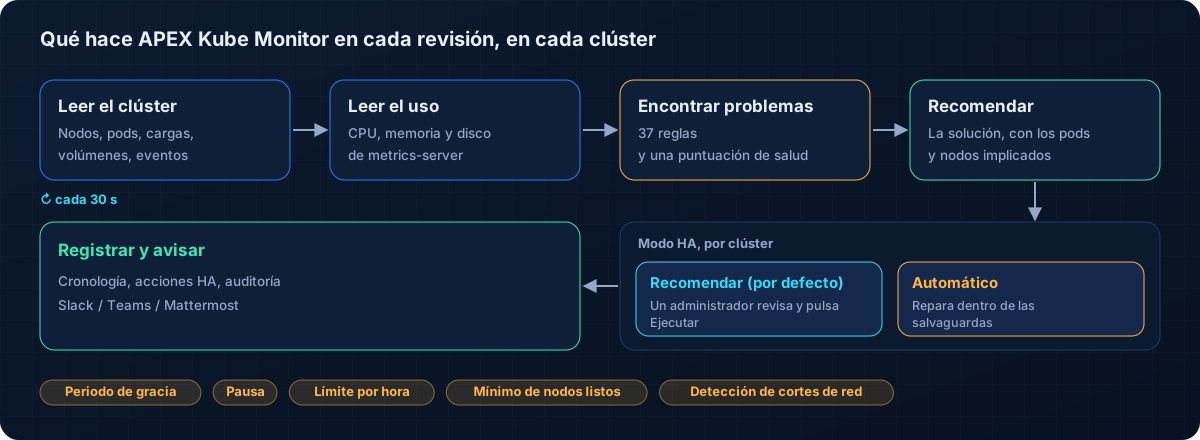
Qué ocurre en cada revisión

Leer el clúster y su uso, encontrar los problemas, recomendar la solución y repararla o dejar que decida un administrador.

Casos de uso

Quién lo usa y para qué

Equipos de operaciones y plataforma

Sepa de un nodo que falla o un disco que se llena antes que los usuarios, con la solución explicada.

Planificación de capacidad

Vea qué aplicaciones cargan qué servidores y si el clúster sobrevive a la pérdida de uno.

Revisiones de resiliencia

Encuentre réplicas únicas, réplicas en el mismo nodo, presupuestos de interrupción ausentes y datos atados a un servidor.

Equipos pequeños sin guardias nocturnas

Deje que las reparaciones rutinarias ocurran solas, dentro de los límites que el equipo ha acordado.

Especificaciones

Especificaciones técnicas

Detalles de despliegue e integración de la versión actual (0.1).

Dentro de su clúster

Una instancia en el clúster que vigila, con una cuenta de servicio que solo puede leer, más los pocos cambios que necesitan sus reparaciones.

Aplicación de escritorio

El mismo monitor en un ordenador, conectado a sus clústeres con un kubeconfig.

Acceso al clústerCuenta de servicio en el clúster, URL de la API y token, o kubeconfig con credenciales incluidas; permisos listados en un solo fichero
Datos leídosNodos, pods, cargas de trabajo, presupuestos de interrupción, volúmenes, clases de almacenamiento, eventos, metrics-server y estadísticas del kubelet
Intervalo30 segundos por defecto, ajustable; historial de 24 horas con una muestra por minuto
Análisis37 tipos de problema con recomendaciones y una puntuación de salud
Reparaciones7 acciones; modos desactivado, recomendar (por defecto) y automático, con periodo de gracia, pausa, límite por hora, mínimo de nodos listos y detección de cortes de red
AlertasWebhooks a Slack, Microsoft Teams y Mattermost
SeguridadCortafuegos por lista permitida, contraseña y MFA TOTP, credenciales cifradas, contraseñas con scrypt, tokens de API guardados como hash
OperaciónRegistro de auditoría y actividad, logs JSON reenviados a un SIEM, copia y restauración, estado de salud para APEX Pingmora
PlataformasSe ejecuta dentro de un clúster Kubernetes; aplicación de escritorio para Windows, macOS y Linux
No incluidoNo puede avisar de que su propio clúster ha caído por completo (combínelo con una comprobación externa como APEX Pingmora); el uso real requiere metrics-server; los datos en volúmenes locales no pueden seguir a su aplicación a otro nodo

APEX Kube Monitor

Preguntas técnicas

¿Cambiará nuestro clúster sin preguntar?

No. El modo por defecto solo recomienda, y un administrador ejecuta cada reparación. La reparación automática se activa por clúster, e incluso entonces las salvaguardas limitan lo que puede ocurrir.

¿Qué permisos necesita?

Lectura del clúster, más solo los cambios que necesitan sus reparaciones. Los permisos están en un solo fichero y se pueden reducir; el monitor los comprueba y muestra lo que no puede hacer.

¿Y si cae todo el clúster?

Un monitor dentro de un clúster no puede avisar de que ese clúster ha caído por completo. Combínelo con una comprobación externa: APEX Pingmora lee su estado de salud.

¿Necesitamos metrics-server?

Para ver el uso real de CPU, memoria y disco, sí. Sin él el monitor sigue funcionando, pero muestra los recursos solicitados en lugar de los que se usan.

Mantenga sanos sus clústeres Kubernetes

Reserve una demo y vea cómo Kube Monitor explica cada problema de un clúster y repara los rutinarios.

Contacto

Hablemos de su seguridad

Cuéntenos sobre su empresa y lo que le preocupa. Un especialista le responderá con los siguientes pasos y, si lo desea, programará una evaluación inicial gratuita o una demostración.

Qué ocurre después

  • Un especialista lee su mensaje y le responde
  • Una breve llamada para entender sus necesidades
  • Una evaluación gratuita o una demostración a medida

Al enviar se abre su aplicación de correo con el mensaje preparado. Este sitio no almacena nada.